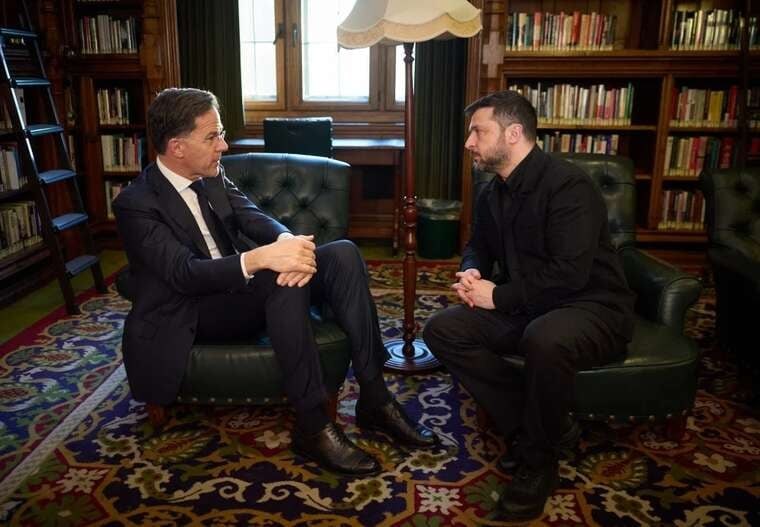
Зеленский и Рютте в Дублине: дефицит ракет ПВО и проблемы Starshield
Президент Украины обсудил с генсеком НАТО Марком Рютте постоянный дефицит средств противоракетной обороны и сбои в работе спутниковой системы Starshield.
Президент Украины обсудил с генсеком НАТО Марком Рютте постоянный дефицит средств противоракетной обороны и сбои в работе спутниковой системы Starshield.
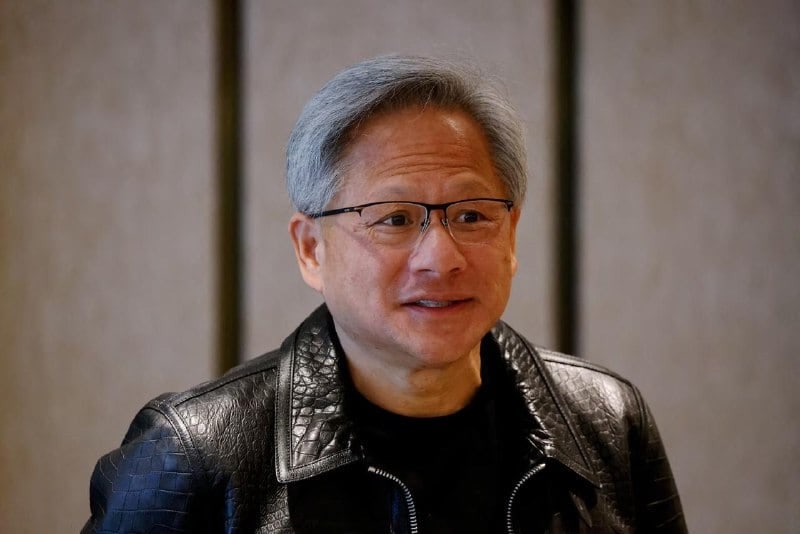
По данным Reuters, Хуанг поддерживал отношения еще с одной сотрудницей компании, что увеличивает число его партнерш до трех.
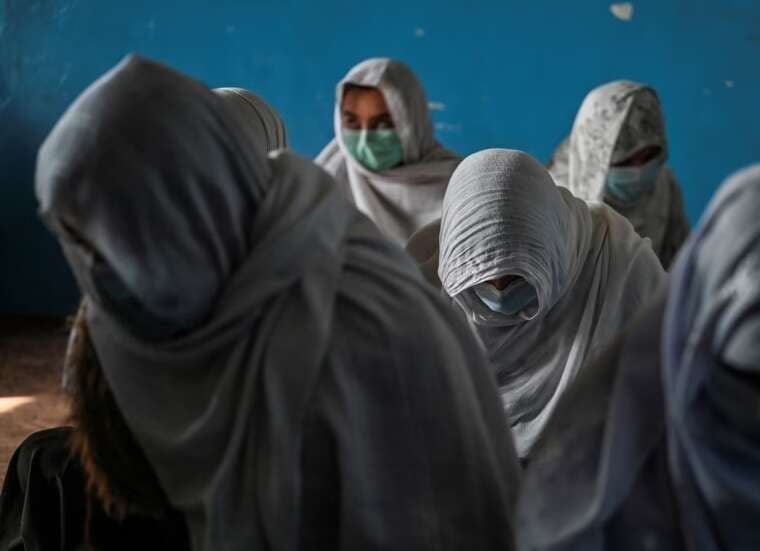
Неофициальные директивы движения «Талибан» усложняют доступ женщин к медицинской помощи, заставляя пациенток искать врачей-родственников в отдаленных городах.
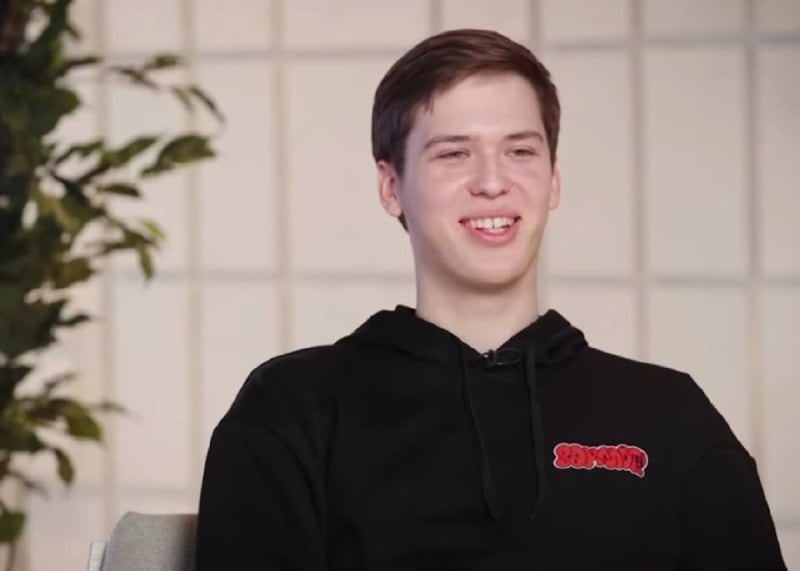
Мэр Днепра Борис Филатов заявил, что блогер Лаченков содействовал российской информационной атаке, распространяя фейки о уголовном деле против него.
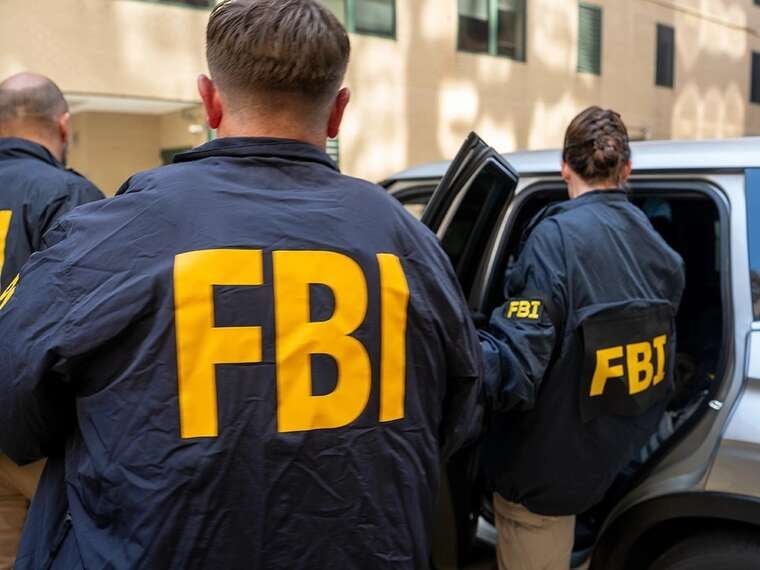
Американские правоохранители совместно с европейскими коллегами проводят проверку сети телефонных афер, офисы которой находились в Украине.
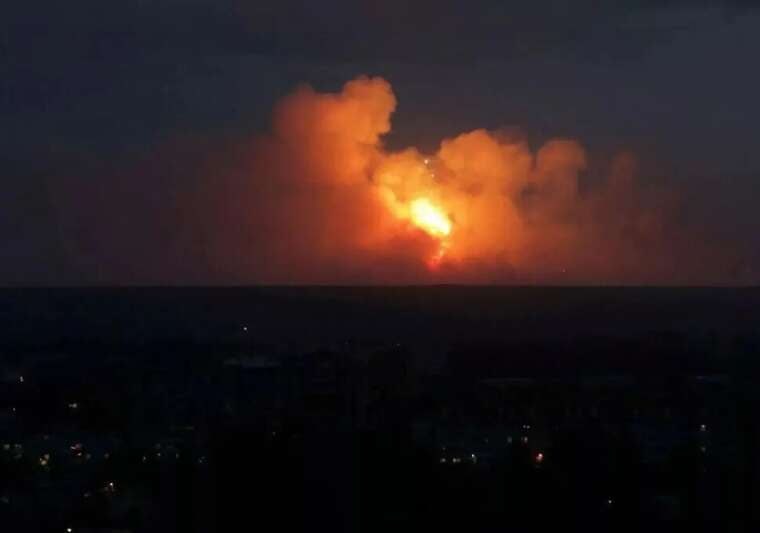
В сети появились видео с моментом взрыва на Ровенщине. На данный момент неизвестны причины инцидента и наличие пострадавших.
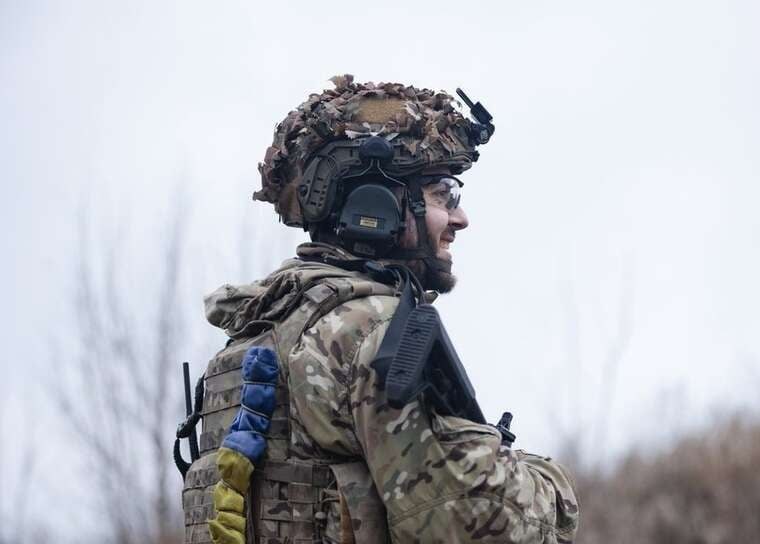
Мониторинговый проект DeepState сообщил, что украинские войска продолжают оборону Константиновки, отбивая попытки противника создать кольцо окружения.
В производственном помещении предприятия возник масштабный пожар после взрыва. Официально причиной названа неисправность электрооборудования.

Китайский стартап в области искусственного интеллекта DeepSeek потратил примерно $1,6 млрд на обучение своей большой языковой модели R1, обладающей способностью к мышлению, несмотря на то, что ранее сообщалось о гораздо меньших расходах — всего $6 млн. Об этом говорится в отчете аналитической компании SemiAnalysis.
Стоимость обучения модели DeepSeek-R1 стала предметом активных обсуждений, поскольку стартап сумел достичь уровня компании OpenAI, потратив значительно меньше средств. Согласно информации аналитиков, DeepSeek использует около 50 тысяч ИИ-чипов Hopper от NVIDIA, а также ожидает поставку еще 10 тысяч таких чипов.
Из-за американских экспортных ограничений на технологии для Китая стартап вынужден применять не только чипы H100, которые до появления BlackWell считались лидерами в отрасли, но и менее мощные чипы H800, а также специально разработанные для китайского рынка H20 и A100.
Среди используемых чипов наибольшую часть занимают H20 — около 30 тысяч, с учетом дополнительных заказов. Также в распоряжении компании находятся примерно по 10 тысяч чипов H100, H800 и A100.
Комментарии
К этой новости пока нет комментариев. Будьте первым!